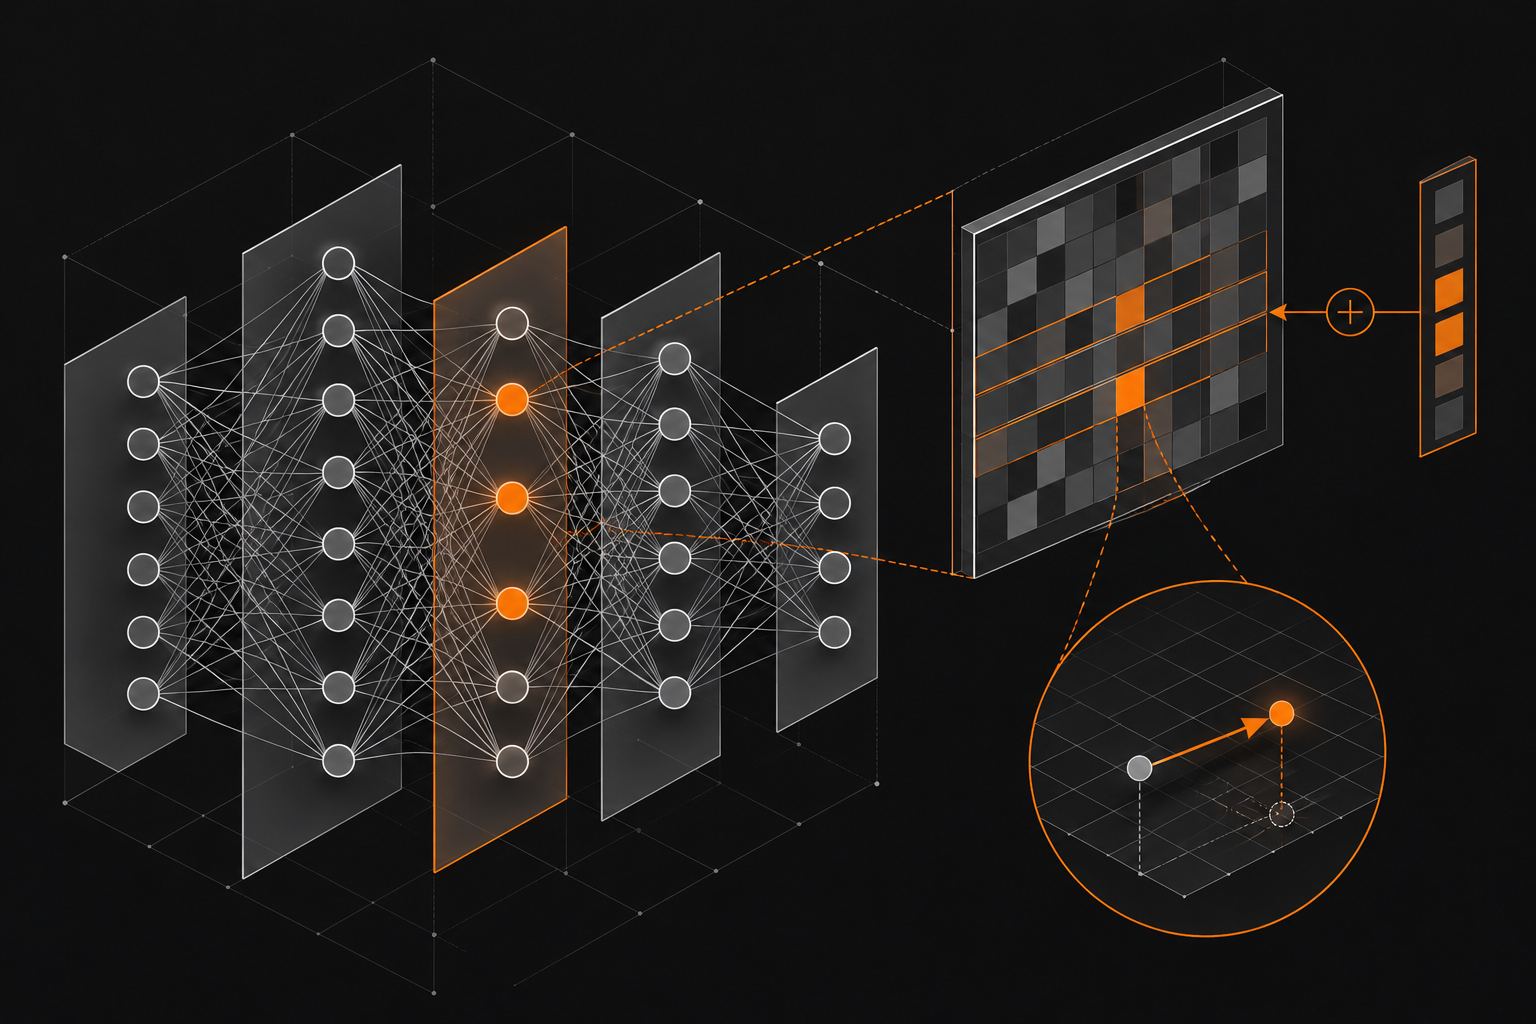
Los modelos de IA suelen cambiar durante el entrenamiento: un algoritmo ajusta millones de valores internos para reducir los errores. Un equipo de investigadores del MIT ha explorado otra vía: pedirle a un modelo de lenguaje que examine esos valores y los modifique directamente para corregir un comportamiento concreto.
En uno de los experimentos, GPT-6 Astra modificó una pequeña parte de los pesos de Qwen3.5-0.8B. Los investigadores observaron una mejora en pruebas de matemáticas e instrucciones al reducir un problema de respuestas que entraban en bucle. El resultado es interesante, pero tiene una distinción importante: corregir un bloqueo no demuestra que el modelo haya aprendido a razonar mejor.
Qué son los pesos
Los pesos son los valores numéricos que determinan cómo se combinan las señales dentro de una red neuronal. Durante el entrenamiento habitual, un optimizador los ajusta usando información sobre el error. En el enfoque que los autores llaman weight-space programming, un modelo generalista analiza y modifica directamente algunos de esos valores para intentar conseguir un objetivo descrito en lenguaje natural.
No se trata simplemente de escribir un prompt para cambiar una respuesta. El objeto modificado es el propio modelo: si se guardan los nuevos pesos, el cambio forma parte de esa copia de la red. En los experimentos descritos, los investigadores impidieron utilizar entrenamiento o descenso por gradiente para realizar los ajustes.
El experimento con Qwen
Según la publicación de los investigadores, Astra recibió acceso mediante una sesión de Python a los pesos de Qwen3.5-0.8B, problemas de práctica y un presupuesto limitado de ejecuciones para observar su comportamiento. Los conjuntos de evaluación finales no se mostraron al modelo encargado de modificar los pesos.
Con el presupuesto de 50 ejecuciones de prueba, Astra identificó un patrón asociado a bucles de razonamiento y alteró 131.072 pesos, aproximadamente el 0,016 % del modelo. En la configuración del estudio, la puntuación en MATH-500 pasó del 7,9 % al 48,1 %, y en GSM8K del 13,8 % al 67,1 %. En IFEval, una prueba de seguimiento de instrucciones, pasó del 21,0 % al 62,3 %.
Las condiciones importan. Los autores utilizaron el modo de razonamiento y permitieron hasta 32.768 tokens por respuesta, con parámetros de muestreo concretos. En MATH-500, el porcentaje de respuestas que agotaron ese límite pasó del 93 % al 33 %. Qwen ya advertía en su ficha del modelo de su tendencia a entrar en bucles. Los números son resultados de ese montaje, no una promesa de mejora para cualquier instalación de Qwen.
Qué se ha corregido
La explicación de los autores es que la edición eliminó parte de una dirección interna asociada al comportamiento repetitivo. Si el modelo deja de repetir y alcanza una respuesta, puede resolver problemas que ya era capaz de abordar, aunque sus capacidades matemáticas no hayan cambiado. Esa diferencia limita lo que se puede concluir de la subida en las pruebas.
El propio estudio ofrece un contraste: en Gemma 3 270M, que apenas presentaba ese problema de bucles, las ediciones no consiguieron una mejora matemática estable. Astra encontró errores de razonamiento más variados, sin una única pieza identificable que bastase con corregir.
Redes pequeñas y juegos
Los investigadores también probaron la lectura y escritura de pesos en redes más pequeñas. En una prueba, facilitaron a Astra los pesos de cuatro redes con la misma arquitectura y la descripción de sus entradas y salidas; identificó los juegos simplificados para los que habían sido entrenadas. En otra, generó pesos para redes que jugaban a tres juegos MinAtar y superó a una referencia concreta entrenada con aprendizaje por refuerzo durante 100 millones de pasos.
Estas comparaciones dependen de arquitecturas, reglas y condiciones de evaluación específicas. En otras pruebas sí se permitió usar herramientas y ejecutar las redes un número limitado de veces. No sería correcto describir todos los resultados como modificaciones hechas sin ninguna observación del comportamiento.
Qué falta por comprobar
El trabajo presenta resultados tempranos, no un método demostrado para reparar cualquier modelo. Los autores no consiguieron identificar un modelo complaciente frente a otro solo leyendo sus pesos: necesitaron observar patrones de atención obtenidos al ejecutar ambos. Y la mejora de Qwen se concentra en un fallo concreto bajo las condiciones descritas.
Para quien ejecuta modelos locales, la idea abre una pregunta práctica: si se identifican comportamientos internos concretos, ¿podrían corregirse sin volver a entrenar toda la red? Antes de aplicar una edición a un servicio real harían falta pesos y procedimientos verificables, pruebas independientes con las tareas propias y una comparación con la configuración original. El estudio completo detalla los experimentos y sus límites.